Die Richtung umdrehen: vom Objektspeicher zurück aufs NAS
Worum es geht Link zu Überschrift
Ein Mietserver sichert sich nachts mit restic in einen Objektspeicher. Zuhause holt sich das NAS sonntags eine Zweitkopie davon. Die Richtung war bewusst so gewählt: Das NAS zieht, also muss zuhause kein Port offen sein.
Dieser Aufbau ist gescheitert — nicht an einem Fehler, sondern an einer Rechnung, die nie jemand gemacht hat. Beim Umbau sind dann zwei Konfigurationsfehler aufgefallen, die vorher unsichtbar geblieben waren. Der eine ist der eigentliche Grund für diesen Beitrag.
Der Auslöser Link zu Überschrift
Eine Mail von Backblaze, 06:03 Uhr: Download Bandwidth Cap Reached 100%. Nicht zum ersten Mal.
Das ist unangenehmer, als es klingt. Ist der Download-Cap erreicht, beantwortet
B2 jeden Download mit einem 403. Und restic liest vor jeder Operation zuerst
die config-Datei im Repo. Ein gerissener Lesezähler blockiert damit auch das
Schreiben. Den ganzen Tag war keine einzige Operation gegen das Repo möglich —
kein snapshots, kein stats, kein Backup.
Merksatz: Wer Egress und Verfügbarkeit koppelt, hat keine Bremse gebaut, sondern eine Kaskade.
Die Diagnose Link zu Überschrift
Der Reihe nach, und bewusst mit Mitteln, die selbst keine Bytes kosten:
- Das nächtliche Backup lief um 03:08 sauber durch, in neun Sekunden. Der Cap wurde also nach dem Backup gerissen, nicht davon.
- Kein zweiter Verbraucher auf dem Server. Kein
prune-Timer, kein Cron-Eintrag, nur die eine systemd-Unit referenziert restic. - Der Cache war warm und wurde seit Wochen durchgehend beschrieben. Es wird also nichts unnötig nachgeladen.
- Die Snapshot-Grössen im lokalen Log zeigten einen Sprung von +417 MiB pro Tag über mehrere Tage, danach flach. Ursache waren täglich neu komprimierte PostgreSQL-Dumps. Jede Kompression erzeugt andere Bytes, also kann restic nichts deduplizieren. Nach der Umstellung auf unkomprimierte Dumps war der Effekt weg — der Grundbedarf des Repos aber dauerhaft höher.
- Live-Test:
restic statslief in einb2_download_file_by_name: 403. Der Cap war in diesem Moment gerissen, nicht nachträglich rekonstruiert. - Im Panel des Objektspeichers: drei Application Keys. Neben dem Master Key und dem Schreibschlüssel des Servers ein dritter, ausschliesslich mit Leserechten. Das Rechteprofil eines ziehenden Verbrauchers.
- Auf dem NAS: das Verzeichnis der Zweitkopie, Zeitstempel in
data/alle sonntags, alle exakt 06:00. Die Mail kam um 06:03. - Das Skript: rclone
copymit--transfers 8, ohne--bwlimit. Acht parallele Ströme mit voller Leitung ziehen ein Gigabyte in drei Minuten.
Der Denkfehler Link zu Überschrift
Zwei Zahlen aus demselben Free Tier waren vertauscht worden:
| Kategorie | Freikontingent |
|---|---|
| Speicher | 10 GB dauerhaft |
| Download | 1 GB pro Tag |
Sie stehen in der Dokumentation direkt untereinander. Die Verwechslung ist folgenreich, weil sie eine strukturelle Unmöglichkeit verdeckt:
Ein Repo von 2,6 GB lässt sich mit einem Tagesbudget von 1 GB nie an einem Tag vollständig lesen. Jede ziehende Zweitkopie ist zum Scheitern verurteilt, sobald das Repo über die Tagesgrenze wächst.
Anfangs fiel das nicht auf, weil nur das Wochendelta geholt wurde und das klein genug war. Seit die Dumps unkomprimiert im Repo liegen, ist das Delta über die Grenze gewachsen. Ab diesem Punkt kommt der Job strukturell nicht mehr durch, egal wie oft er es versucht.
Dazu kommt ein zweiter Punkt, den die Fehlermeldung gar nicht anspricht: Ein NAS, das aus dem Objektspeicher zieht, bezahlt jedes Byte zweimal. Einmal beim Hochladen vom Server, einmal beim Herunterladen. Dabei liegen die Quelldaten auf dem Server ohnehin lokal vor.
Die Entscheidung Link zu Überschrift
Das Download-Budget bleibt bei null — keine Kosten, auch nicht potenziell. Der Preis dafür ist, dass jede Operation unter einem Gigabyte bleiben muss.
Gelöst wird das nicht mit einem höheren Budget, sondern mit der Umkehr der Richtung: Der Server schiebt direkt aufs NAS. Der Objektspeicher wird damit ein reines Schreibziel, der Download-Cap nie wieder angefasst.
Der Haken gehört benannt. Ein ziehendes NAS hat keine Schreibrechte auf die
Quelle: Wird der Server kompromittiert, ist die Zweitkopie sicher. Beim Push ist
es umgekehrt. Das Gegenmittel heisst --append-only im rest-server: Der Server
darf schreiben, aber nicht löschen. Das ist aktiv — und genau deshalb liegt das
Aufräumen des Repos auf dem NAS und nicht beim Server. Wer nicht löschen darf,
kann auch nicht aufräumen.
Merksatz: Pull schützt die Quelle, Push braucht
--append-only. Beides sind legitime Modelle. Man muss nur wissen, welches man gewählt hat und warum.
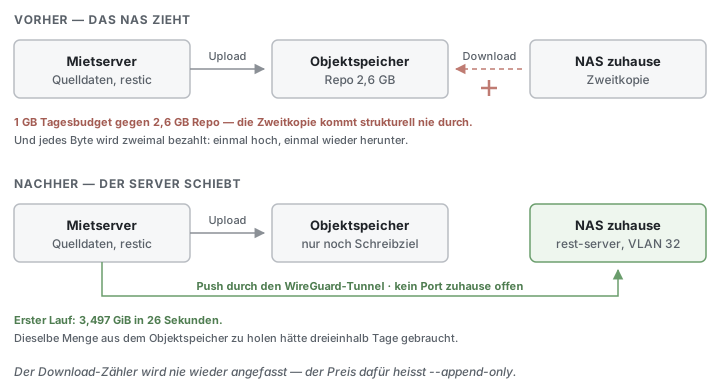
Dieselben drei Beteiligten, eine Richtung anders — und aus einer Unmöglichkeit werden 26 Sekunden.
Der Umbau Link zu Überschrift
Das Problem zuerst: Der DSM-Kernel des NAS ist 4.4 und kennt kein WireGuard, das kam erst mit 5.6. Ein Container kann kein Kernelmodul laden, das nicht existiert. Der direkte Weg über die Synology fiel damit weg.
Die Lösung war naheliegender, als sie zuerst aussah: Die OPNsense ist seit Teil 11 schon WireGuard-Endpunkt. Der Mietserver wird einfach ein weiterer Peer. Damit bleibt die ursprüngliche Eigenschaft des Aufbaus erhalten — kein zusätzlicher Port zuhause offen.
Drei Details, die Substanz haben:
- Die Tunneladresse
10.0.60.99, bewusst weit oberhalb der bestehenden Client-Adressen. Der Sprung macht schon beim Draufschauen sichtbar, dass das kein normaler Roaming-Client ist. - Eine zweite Schnittstelle
wg1auf dem Server. Dessenwg0ist eine eigene, unabhängige Instanz für einen anderen Zweck. Die beiden dürfen nicht vermischt werden. AllowedIPsauf Serverseite nur die NAS-Adresse, kein0.0.0.0/0. Ein Full-Tunnel hätte den gesamten Verkehr des Mietservers durchs Heimnetz geschickt und alle dort laufenden Dienste lahmgelegt. Die Doppelbedeutung dieses Feldes war schon in Teil 11 Thema.
Gegen eine zweite WireGuard-Instanz habe ich mich entschieden. Sie wäre „getrennter" gewesen, hätte aber einen zweiten offenen UDP-Port am WAN gekostet. Die Trennung leisten hier die Tunneladresse und eine Firewall-Regel. Rechte werden in diesem Netz ohnehin pro Adresse vergeben, nicht pro Instanz.
Der eingeschobene VLAN-Umzug Link zu Überschrift
Mitten im Umbau fiel auf, dass das NAS noch in 10.0.1.0/24 lag — zusammen mit
Firewall, Switch und Virtualisierungshost. Also mitten im Management-Netz.
Ein NAS gehört da nicht hin. Es ist ein Gerät mit vielen offenen Ports, einer Weboberfläche und einem Paketsystem, das man nicht vollständig überblickt. Ausgerechnet dieses neben die Firewall zu stellen, entwertet den Rest der Segmentierung.
Also neues VLAN 32, 10.0.32.0/24. Auf dem OpenWrt (DSA, bridge-vlan): VLAN 32
angelegt mit sfp-wan:t und lan2:u*, dann lan2 aus VLAN 10 entfernt. Welcher
Port der richtige ist, liess sich über die MAC-Tabelle bestimmen — das OUI
90:09:D0 gehört Synology.
Die Firewall-Regeln sind 1:1 die Vierer-Kette aus Teil 10: DNS an die Firewall, NTP, Block auf RFC1918, dann Internet. Die Block-Regel ist der Kern. Wird das NAS kompromittiert, kommt es in kein anderes internes Netz.
Was schiefging Link zu Überschrift
Der Sync, der stillstand Link zu Überschrift
Das ist der bessere der beiden Funde. Nach dem VLAN-Wechsel stellte sich heraus:
Im Synology Drive Client auf der Workstation stand als Ziel noch eine
192.168er-Adresse — falsch seit einem früheren Umbau, und seitdem tot.
Der Client hat deshalb nichts synchronisiert. Nicht wenig, nicht langsam: nichts. Und er hat es nie gesagt. Kein Fehler, keine Warnung, kein rotes Symbol, keine Mail. Die Oberfläche sah aus wie immer.
Aufgefallen ist es erst, als ich nach dem Umzug ins neue VLAN die richtige Adresse eingetragen habe. Da fing er an, den gesamten Rückstand nachzuholen — und erst an dieser Datenmenge war zu sehen, wie lange das schon so ging.
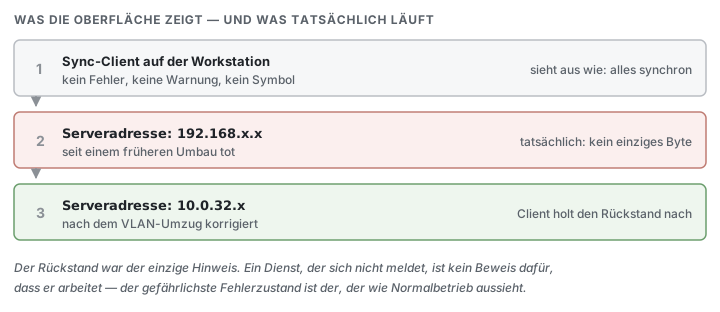
Die Oberfläche war die ganze Zeit unauffällig. Nur die Zahlen waren es nicht.
Das ist exakt dasselbe Muster wie das DynDNS-Skript aus Teil 11. Auch das lief weiter, es lieferte nur nichts.
Merksatz: Ein Dienst, der sich nicht meldet, ist kein Beweis dafür, dass er arbeitet. Der gefährlichste Fehlerzustand ist der, der wie Normalbetrieb aussieht.
Praktisch heisst das: Nach jedem Umbau nicht prüfen, ob etwas läuft, sondern woran es hängt und wann es zuletzt etwas getan hat. Die eingetragene Adresse, die tatsächlich vergebene IP, der Zeitstempel der letzten Übertragung.
Die Regel unter der Block-Regel Link zu Überschrift
Der zweite Fund ist der Klassiker. Die Firewall-Regel für den Port des rest-servers stand unter der Block-Regel auf RFC1918 — und die NAS-Adresse ist eine private Adresse. Also geblockt. Derselbe Fehler wie beim IPTV in Teil 10.
Diagnostiziert über wg show: rund 2,9 KiB gesendet, 624 B empfangen. Diese
Asymmetrie sagt alles — die Pakete gehen raus, es kommt nichts zurück, die Kette
reisst also hinter dem Tunnel. Das Live-Log der Firewall zeigte dann die
geblockten Zeilen im Klartext. Die Methode „von aussen nach innen prüfen" aus
Teil 11 hat sich damit zum zweiten Mal bewährt.
Der Nebengewinn Link zu Überschrift
Beim Vergleich der beiden Repos kam etwas Unerwartetes heraus. Die alte NAS-Kopie ist ein Superset des Objektspeichers:
| NAS | Objektspeicher | |
|---|---|---|
| Snapshots | 32 | 12 |
| Pack-Dateien | 293 | 202 |
| Grösse | 4,1 GB | 2,6 GB |
Der Grund: Das Skript nutzte copy, nicht sync. Löschungen wurden also bewusst
nicht gespiegelt. Damit enthält die Kopie noch die Snapshots aus dem August, die
ein prune im Quell-Repo längst entfernt hat. Ein Kommentar im Skript sagt genau
das — eine alte Entscheidung, die sich unerwartet ausgezahlt hat.
Und weil die Kopie lokal liegt, war zum ersten Mal ein restic check --read-data
möglich: 293 Packs, 77 Sekunden, keine Fehler. Das ist die erste inhaltliche
Verifikation dieses Repos überhaupt. Gegen einen Objektspeicher mit erschöpftem
Tagesbudget ist diese Prüfung schlicht nicht durchführbar.
Dazu noch eine Zahl, die am nächsten Tag im frischen Budgetfenster herauskam:
prune hätte in diesem Repo 336 MiB freigegeben, gut ein Prozent der
Gesamtgrösse. Praktisch ein No-op. Die Snapshots, die forget täglich verwirft,
teilen sich ihre Blobs fast vollständig mit den verbleibenden. Die Sorge „ohne
Timer wächst das Repo still" trifft hier nicht zu.
Wo ich jetzt stehe Link zu Überschrift
Der rest-server läuft als Container auf dem NAS, erreichbar nur über den Tunnel und nur von der einen Serveradresse. Das NAS liegt in VLAN 32 und kommt von dort in kein anderes internes Netz.
Der erste Lauf: 3,497 GiB in 26 Sekunden. Zum Vergleich: Dieselbe Datenmenge aus dem Objektspeicher zu holen hätte bei einem Gigabyte pro Tag dreieinhalb Tage gebraucht. Das ist der Unterschied zwischen Push und Pull in einer Zahl.
restic check: no errors were found.
Das NAS-Repo ist bewusst frisch initialisiert und nicht die alte Kopie. Zwei Repos mit identischer ID würden sich auf dem Server denselben Cache teilen — die Sorte Fehler, die erst beim Restore auffällt.
Der Lauf läuft von allein Link zu Überschrift
Auf dem Server startet ein Timer täglich um 04:00, mit einer Viertelstunde
Streuung und Persistent=true, damit ein verpasster Lauf nachgeholt wird. Die
Unit hat ein Requires=wg-quick@wg1.service. Ohne Tunnel gibt es damit keinen
Lauf — und nicht einen halben.
Drei Dinge im Skript dahinter sind erwähnenswert:
Ein eigener Totmannschalter. Der NAS-Lauf pingt seinen eigenen Check: /start
zu Beginn, /fail über ein trap … ERR, der Erfolgs-Ping am Ende. Genau darum
ging es. Ein ausgeschaltetes NAS meldet jetzt diesen einen Check als überfällig
und lässt das Backup in den Objektspeicher unberührt.
Ein eigener konsistenter Datenbank-Schnappschuss über sqlite3 .backup,
unabhängig vom anderen Backup. Die Live-Datei selbst ist ausgeschlossen — eine
SQLite-Datenbank im laufenden Betrieb einfach mitzukopieren ergibt eine Datei, die
aussieht wie ein Backup und keins ist.
Ein timeout 2h um den restic-Lauf. Ein hängender Lauf blockiert sonst den
nächsten und meldet dabei trotzdem nichts.
Aufgeräumt wird auf dem NAS selbst. Dort ruft ein Container am ersten jedes Monats
um 05:00 forget mit --keep-daily 7 --keep-weekly 4 --keep-monthly 6 --prune
auf. Das Aufräumen liegt damit bei dem, der die Daten hält, nicht bei dem, der sie
schickt.
Nächster Schritt Link zu Überschrift
Ein Punkt ist noch offen, und der gehört hier hin statt in eine Schublade: Die alte Pull-Kopie liegt unverändert unter ihrem alten Namen neben dem neuen Repo. Sie enthält 32 Snapshots mit den August-Ständen, die es sonst nirgends mehr gibt. Sie muss umbenannt und als Archiv eingefroren werden, damit sie nicht irgendwann versehentlich in ein Aufräumen gerät — ausgerechnet die Kopie, die als einzige etwas enthält, das nicht mehr reproduzierbar ist.
Danach ist die Strecke rund: eine Sicherung nach aussen, eine im Haus, beide überwacht, beide geprüft.
Geschrieben im September 2026.